Dass Software heute zu erheblichen Teilen von Maschinen geschrieben wird, ist keine Nachricht mehr. In vielen Entwicklungsteams entsteht der Code längst nicht mehr Zeile für Zeile von Hand. Wer darin den eigentlichen Umbruch sieht, hat ihn bereits verpasst.
Der Umbruch, über den ich hier schreiben will, ist ein anderer. Und er hat für mich kürzlich eine sehr konkrete Form angenommen: Ich habe ein System gesehen, dessen Ergebnis kein Quelltext mehr ist.
Drei Ebenen, und was gerade zusammenfällt
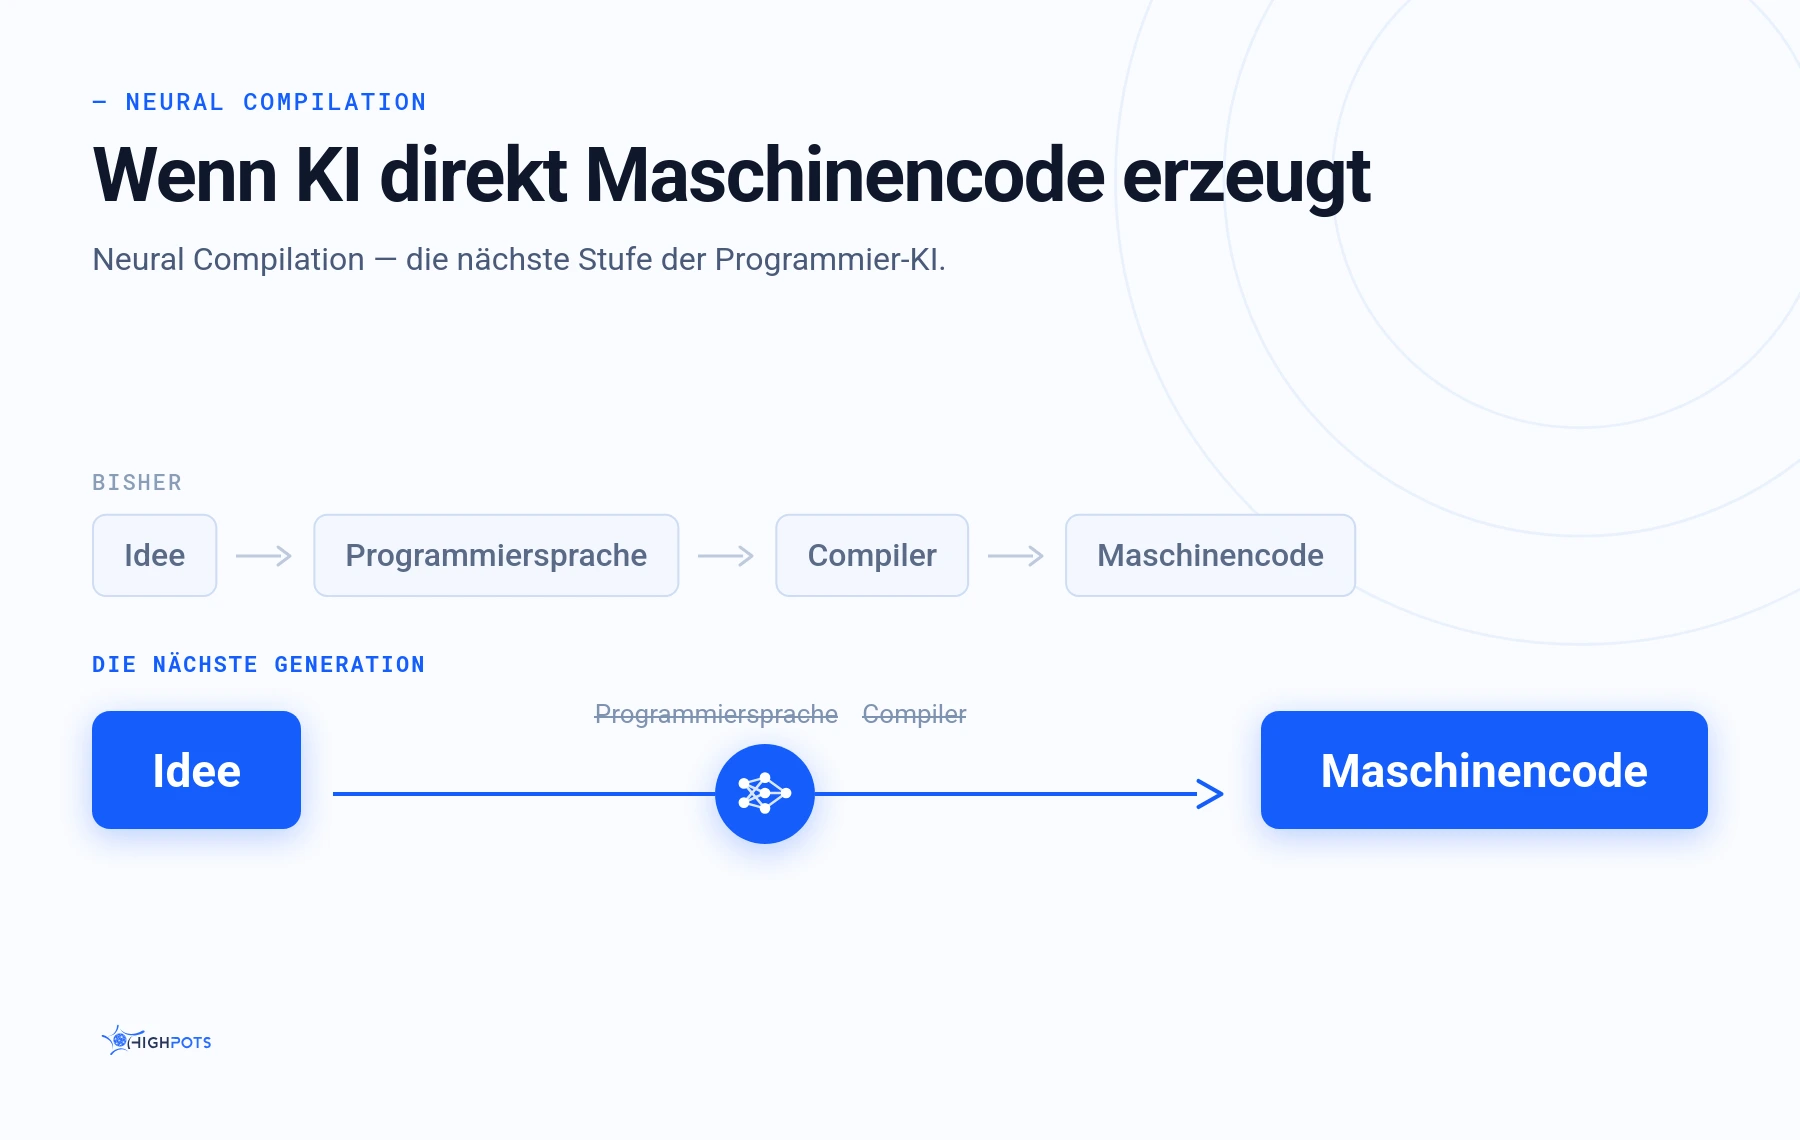
Ein kurzer Rückblick für alle, die nicht täglich mit Software zu tun haben. Software entsteht seit Jahrzehnten in drei Schichten. Oben steht eine Hochsprache – Java, Python, C# –, geschrieben für Menschen, lesbar und diskutierbar. Ganz unten steht Maschinencode: Zahlenfolgen, die ein Prozessor unmittelbar ausführt. Dazwischen liegt Assembler, im Kern nichts anderes als die für Menschen lesbare Schreibweise des Maschinencodes – ein Befehl entspricht in der Regel einer Maschineninstruktion.
Zwischen der oberen und der unteren Schicht arbeitet der Compiler. Er übersetzt das, was Menschen geschrieben haben, in das, was die Maschine ausführt. Diese Aufgabenteilung ist rund siebzig Jahre alt und war in dieser Zeit die stabilste Konstante der Informatik.
Was ich gesehen habe, lässt sich in dieser Leiter nicht verorten. Es war keine Hochsprache. Es war kein Assembler. Es war auch nicht das, was ein handelsüblicher Prozessor als Befehl entgegennimmt. Prozessor und erzeugendes Modell stammten aus derselben Entwicklung, und die Anforderung des Anwenders ging unmittelbar in die Hardware. Ich kann nicht sagen, was ich da vor mir hatte – ich kann sagen, dass es unterhalb von allem lag, was ich in dreißig Jahren mit Software je zu Gesicht bekommen habe, und dass an keiner Stelle des Weges etwas entstand, das ein Mensch hätte lesen können.
Ich bin mir bewusst, dass ich diesen Punkt als persönliche Beobachtung setze und nicht als publizierten Forschungsstand. Die öffentlich zugängliche Forschung setzt eine Stufe höher an: Dort erzeugen die Verfahren Assembler – und Assembler ist, bei aller Sperrigkeit, noch eine Schreibweise für Menschen. Ein Befehl, eine Zeile, ein lesbares Kürzel. Solange das Ergebnis Assembler ist, bleibt die Kette eng, aber sie bleibt geschlossen.
Was ich gesehen habe, kennt diese Stufe nicht. Das Ergebnis ist keine Schreibweise, sondern das, was die Elektronik unmittelbar ausführt – ohne dass an irgendeiner Stelle des Weges eine für Menschen lesbare Fassung entstanden wäre. Nicht als Zwischenschritt, nicht als Nebenprodukt, gar nicht. Man mag das für einen Einzelfall halten. Ich halte es für einen Vorlauf.
Warum der Compiler mehr war als ein Werkzeug
Es lohnt sich, kurz innezuhalten und zu fragen, was wir eigentlich verlieren. Denn das erste Gegenargument liegt nahe: Den Maschinencode hat doch ohnehin nie jemand gelesen. Compiler-Ausgaben prüft kein Mensch. Wir leben seit Jahrzehnten mit einer undurchsichtigen Übersetzungsschicht – warum sollte eine weitere undurchsichtige Schicht ein Problem sein?
Weil der Compiler zwei Eigenschaften hat, die eine KI nicht hat.
Er ist deterministisch. Dieselbe Eingabe erzeugt dieselbe Ausgabe, heute, morgen und in fünf Jahren. Und er ist über Jahrzehnte gehärtet worden; für einen C-Compiler existiert sogar eine formal verifizierte Variante, deren Korrektheit mathematisch bewiesen ist.
Vor allem aber: Der Quelltext blieb erhalten. Wir konnten die Übersetzung jederzeit neu anstoßen und das Ergebnis gegenprüfen. Genau deshalb war die Undurchsichtigkeit des Compilers erträglich – es gab immer ein verbindliches Original, aus dem sich alles wieder ableiten ließ.
Fällt beides zusammen weg, ist die Kette an keiner Stelle mehr geschlossen. An die Stelle eines deterministischen, kostenlosen Übersetzers tritt ein stochastischer, kostenpflichtiger Erzeuger. Und es gibt kein Original mehr, gegen das man prüfen könnte.
Was stirbt, was überlebt
An dieser Stelle wird es für Unternehmen praktisch. Es lohnt sich, sauber zu trennen, was tatsächlich wegfällt und was bleibt – weil beides oft in einen Topf geworfen wird.
Was überlebt: Alles, was Verhalten prüft. Ein Test, der eine Rechnung hineingibt und kontrolliert, ob der richtige Betrag herauskommt, funktioniert weiter. Integrationstests, End-to-End-Tests, fachliche Abnahmen – all das ist unabhängig davon, wie das System innen aussieht.
Was stirbt: Alles, was am Quelltext hängt. Ein Entwickler kann heute ein Programm anhalten, Zeile für Zeile durchgehen und beobachten, welche Werte sich wie verändern. Er bekommt bei einem Fehler eine Meldung mit Dateiname und Zeilennummer. Werkzeuge prüfen den Code automatisch auf typische Fehlermuster, bevor er überhaupt läuft. Änderungen lassen sich vergleichen, begutachten und einzelnen Personen zuordnen. Nichts davon hat noch einen Gegenstand, wenn es keinen Quelltext gibt.
Übrig bleiben genau zwei Berührungspunkte: Was ich vorne hineingebe, und was hinten herauskommt. Dazwischen: nichts.
Der Punkt, der mir am meisten zu denken gibt
Noch schwerer als das Testen wiegt der Eingriff.
Heute ist die kleinste Änderungseinheit eine Zeile. Ein falscher Steuersatz, eine vergessene Bedingung, ein Rundungsfehler – man ändert die betreffende Stelle, übersetzt neu und ist fertig. Die Änderung bleibt lokal. Alles andere bleibt exakt, wie es war.
Ohne Quelltext ist die kleinste Änderungseinheit die Beschreibung des Systems. Man ändert die Anforderung und lässt neu erzeugen. Das Ergebnis kann an jeder beliebigen Stelle anders ausfallen, auch dort, wo man nichts ändern wollte. Keine kleine Änderung bleibt klein.
Für ein System, das seit sieben Jahren im Betrieb ist und an dem eine Kleinigkeit angepasst werden soll, ist das ein struktureller Unterschied.
Vier Einwände – und warum sie mich nicht überzeugen
Ich habe diese Überlegungen mit einigen Leuten durchgesprochen. Es kommen immer wieder dieselben vier Entgegnungen, und sie sind alle berechtigt. Ich halte sie trotzdem für nicht tragfähig.
„Dann lässt man sich eben zusätzlich eine lesbare Fassung erzeugen.“
Technisch möglich, ökonomisch unwahrscheinlich. Wer so vorgeht, zahlt dreimal: für die Erzeugung des Maschinencodes, für die Erzeugung der lesbaren Fassung – und weiterhin für die Menschen, die diese lesbare Fassung überhaupt verstehen können. Genau diese Personalkosten sind aber der Grund, aus dem der Weg eingeschlagen wird. Man führt eine Rationalisierung durch und finanziert gleichzeitig weiter, was rationalisiert werden sollte.
Und selbst wenn man es täte: Die lesbare Fassung wäre nicht die Quelle, sondern eine Beschreibung. Niemand garantiert, dass sie zum tatsächlich ausgeführten Code passt. Wer auf ihrer Grundlage eine Änderung plant, plant gegen ein Dokument, das abweichen kann. Das sind die Kosten der Quelltextpflege ohne deren Verlässlichkeit.
„Regulierte Branchen werden das verhindern.“
Heute stimmt das. In Medizintechnik, Luftfahrt und Automobilbau muss nachvollziehbar sein, wie aus einer Anforderung eine Funktion wurde und wie diese geprüft wurde. Maschinencode ohne Quelle erfüllt das nicht.
Nur: Diese Branchen stehen unter demselben Kostendruck wie alle anderen. Und Nachvollziehbarkeitsregeln sind kein Naturgesetz, sondern Vereinbarungen. Sie sind entstanden, weil sie zur damaligen Technik passten, und sie werden angepasst werden, wenn die Technik sich ändert und der wirtschaftliche Druck groß genug ist. Wer glaubt, die Regulierung halte eine Entwicklung dauerhaft auf, die überall sonst Kosten senkt, unterschätzt, wie beweglich Regulierung ist.
„Man kann aus Maschinencode jederzeit wieder lesbaren Code gewinnen.“
Das ist richtig, und ausgerechnet KI-Modelle sind darin gut. Aus einer Binärdatei lässt sich mit passenden Werkzeugen etwas rekonstruieren, das wie Quelltext aussieht und sich lesen lässt.
Und es wird schnell besser. Das erste offene Modell, das eigens dafür trainiert wurde, erschien 2024 und übertraf allgemeine Sprachmodelle wie klassische Werkzeuge deutlich. Eine Arbeit derselben Forschungsgruppe von 2025 legt noch einmal spürbar nach und schlägt dabei auch aktuelle allgemeine Modelle. Trotzdem gilt für die besten heute gemessenen Verfahren: Rund ein Drittel der rekonstruierten Programme besteht die zugehörigen Tests nicht.
Und darauf kommt es hier nicht einmal an.
Der Unterschied ist trotzdem entscheidend. Man erhält eine Rekonstruktion, keine verbindliche Quelle. Zwei Rekonstruktionen desselben Programms können unterschiedlich ausfallen. Man bekommt eine Ansicht – nicht die Wahrheit. Für das Verständnis reicht das. Für Verantwortung, Prüfung und Haftung nicht.
„Maschinencode ist teuer zu erzeugen, der Compiler ist praktisch umsonst.“
Das ist der stärkste Einwand, und rein rechnerisch stimmt er heute. Maschinennaher Code besteht aus sehr vielen kleinen Einheiten ohne verdichtete Bedeutung; ihn zu erzeugen kostet ein Modell deutlich mehr Aufwand, als eine Hochsprache zu erzeugen. Der Compiler dagegen leistet die Übersetzung zum Preis von nahezu null.
Der Einwand beschreibt allerdings die Ökonomie von heute. Die Kosten für maschinelle Erzeugung fallen seit Jahren in einem Tempo, das jede Momentaufnahme schnell überholt. Und die Entwicklung findet statt – nicht, weil sie billiger wäre, sondern weil sie an einzelnen Stellen leisten kann, was ein regelbasierter Compiler nicht leistet. Was in solchen Nischen beginnt, bleibt selten dort.
Die Frage, die am Ende entscheidet
Ich vermute, dass die Sache nicht an der Technik scheitern oder gelingen wird, sondern an einem Anreizproblem, das jeder aus dem eigenen Haus kennt.
Die Einsparung entsteht heute, bei der Erstellung. Der Schaden entsteht in drei, fünf oder acht Jahren, bei Wartung, Fehlersuche und Prüfung. Das sind in aller Regel unterschiedliche Budgets und fast immer unterschiedliche Personen. Wo dieses Muster auftritt, wird zuverlässig zu wenig investiert – Dokumentation und Testabdeckung sind seit dreißig Jahren die Beispiele dafür, und jeder kennt ihren Wert.
Die lesbare Fassung wird also nicht deshalb unterbleiben, weil sie unmöglich wäre. Sie wird unterbleiben, weil derjenige, der spart, nicht derjenige ist, der die Rechnung bekommt.
Was ich Unternehmen raten würde
Für Unternehmen, die Software einsetzen, aber nicht selbst entwickeln, sind aus alldem drei Dinge relevant.
Erstens: Die Beschreibung Ihres Systems ist Ihr eigentliches Vermögen. Nicht der Code. Wenn präzise festgehalten ist, was Ihr System leisten soll – mit welchen Regeln, welchen Ausnahmen, welchen Grenzfällen –, dann bleiben Sie handlungsfähig, unabhängig davon, womit es implementiert wurde. Wenn dieses Wissen nur in den Köpfen einiger Personen und im Code steckt, wird es teuer. Diese Frage stellt sich übrigens schon heute, völlig unabhängig von KI.
Zweitens: Prüfbarkeit muss eingebaut sein, nicht nachgerüstet. Wenn Sie nicht mehr hineinschauen können, brauchen Sie ein System, das aussagekräftig protokolliert, was es getan hat, und das sich gegen bekannte Ergebnisse abgleichen lässt. Das ist eine Architekturentscheidung und keine, die man später nachholt.
Drittens: Die personelle Rechnung geht auf – aber anders als gedacht. Weil die verhaltensbasierten Tests überleben und die quelltextgebundenen wegfallen, sinkt der Bedarf an Personen, die Code lesen. Er steigt bei Personen, die fachlich präzise beschreiben können, was ein System tun soll, und die beurteilen können, ob ein Ergebnis richtig ist. Das sind andere Profile, und sie sitzen oft näher am Fachbereich als an der IT.
Dieselbe Frage, ein anderes Feld
Dieselbe Frage stellt sich außerhalb der Softwareentwicklung überall dort, wo Systeme anfangen, Entscheidungen selbst zu treffen: Nicht der Grad der Autonomie entscheidet über den Nutzen, sondern ob jeder einzelne Schritt nachvollziehbar bleibt und im Zweifel freigabepflichtig ist. Genau darauf ist AnyAgent ausgelegt – Automatisierung von Prozessschritten, bei der pro Schritt festgelegt wird, was das System selbst ausführt und was einem Menschen vorgelegt wird. Wie wir das Thema insgesamt angehen, haben wir unter KI-Dienstleistungen beschrieben.
